
CloudNativePG(CNPG)의 백업을 오브젝트 스토리지에 보관하고 있는데 요청량 때문에 추가 비용이 발생했습니다. 처음에는 백업이 너무 자주 실행되는 줄 알았습니다. 버킷에 있는 파일 수와 백업 주기부터 확인했지만 요청 그래프를 나눠 보니 다른 쪽을 먼저 봐야 했습니다.
이번에는 백업 주기를 줄이는 대신 복제본을 어떻게 처리할지 정리했습니다. 대상은 같은 복구를 반복하며 스토리지 요청을 발생시키는 복제본입니다. Python으로 장애 판정과 복제본 재생성을 자동화하는 보조 컨트롤러를 만들었고 관찰 모드로 검증한 뒤 운영에 켰습니다. 실제 계정과 인프라 식별자는 빼고 과정을 정리합니다.
백업 파일 수와 API 요청 수는 달랐습니다
버킷의 파일 수는 현재 남아 있는 오브젝트의 개수입니다. 그 파일을 몇 번 읽었는지, 목록을 몇 번 조회했는지는 알려 주지 않습니다. 같은 WAL 파일을 여러 번 찾거나 내려받으면 파일 수가 그대로여도 요청은 늘 수 있습니다. 큰 파일은 나눠 올리는 경우도 있어서 파일 두 개가 생겼다고 요청도 두 번이라고 계산할 수는 없었습니다.
Oracle Cloud의 Metrics Explorer에서 전체 요청, 읽기, 목록 조회, 쓰기를 나눠 봤습니다. 요청이 급증한 구간에서는 쓰기보다 읽기와 목록 조회가 훨씬 컸습니다. 오브젝트 수와 요청 수가 별도 지표라는 점은 공식 메트릭 설명에서도 확인할 수 있습니다.
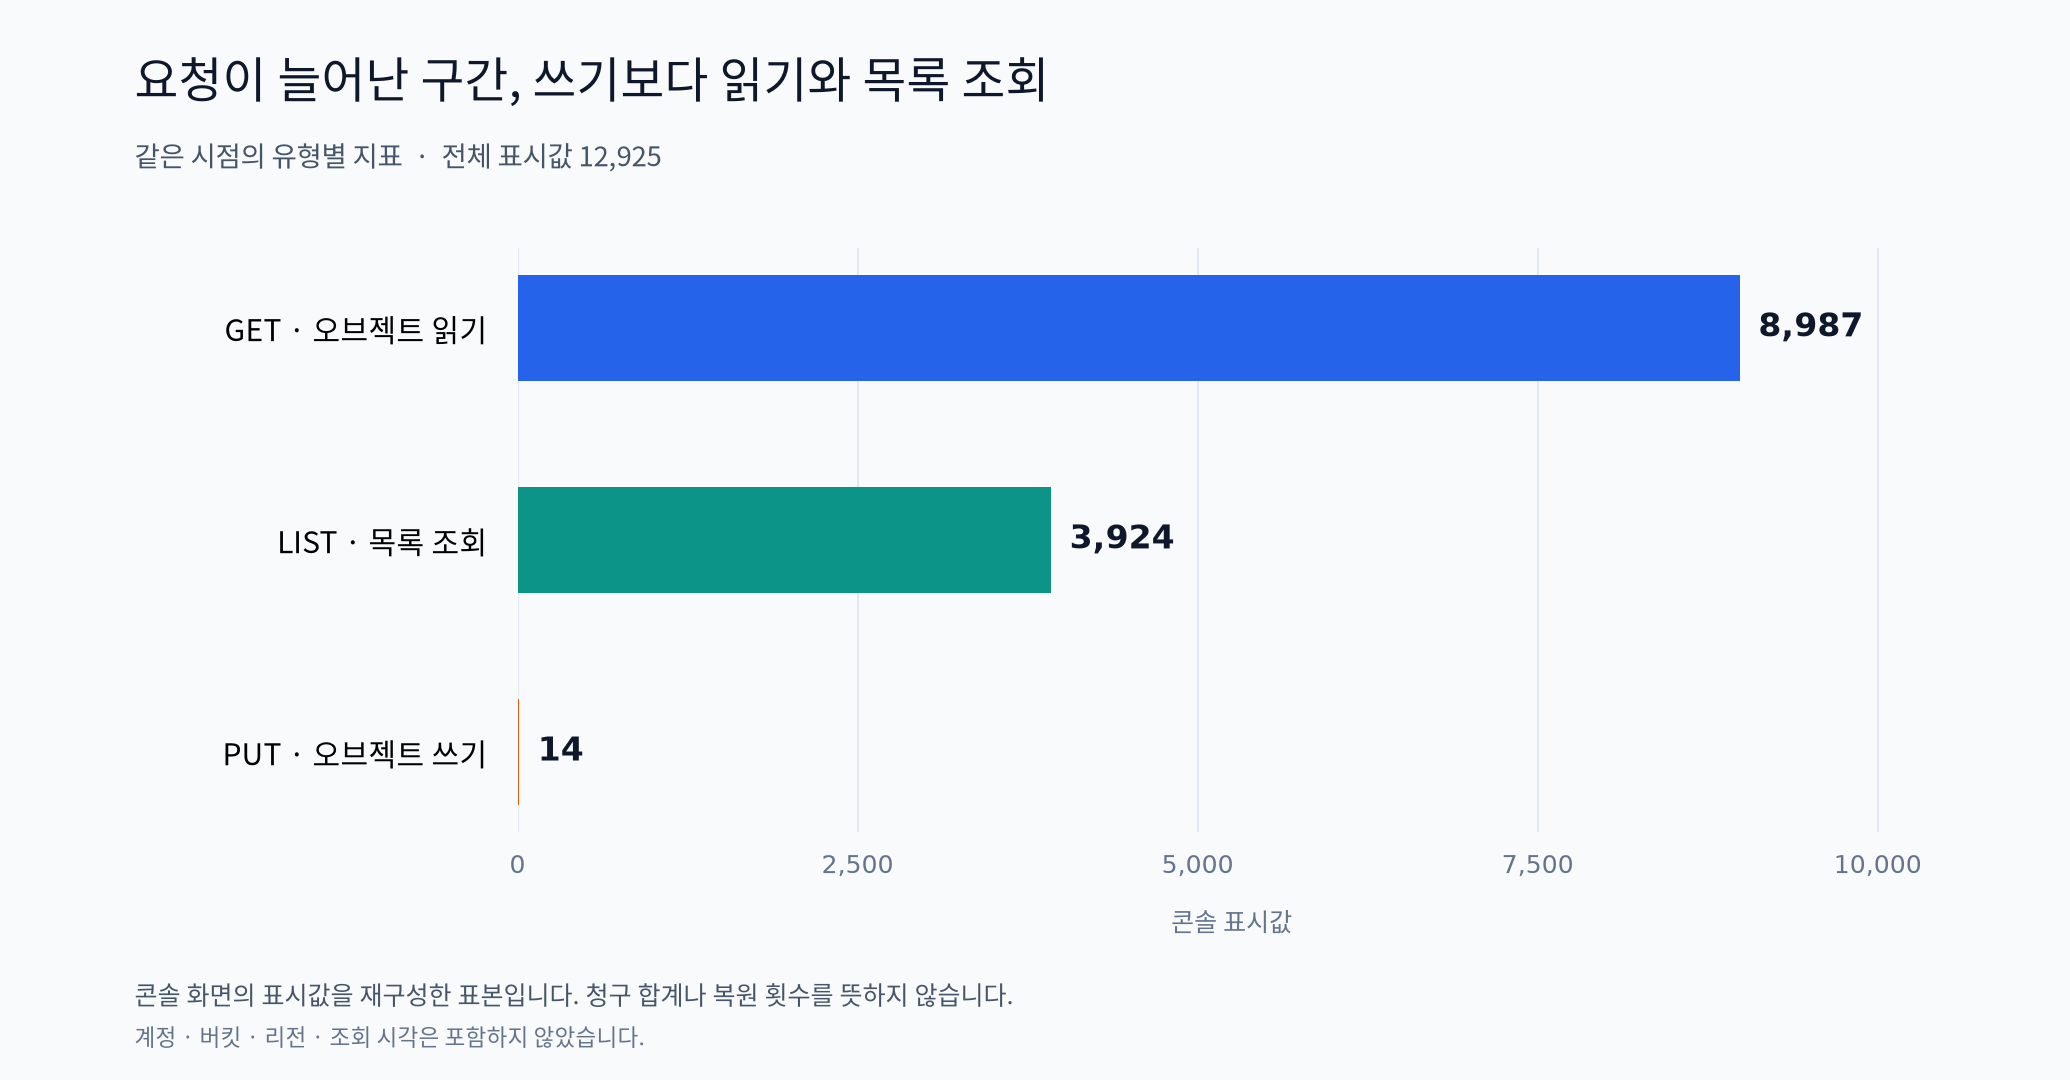
그래프에 사용한 익명화 수치 CSV 내려받기 — 콘솔 화면에서 옮긴 네 개 지표만 포함합니다.
| 지표 | 같은 시점의 콘솔 표시값 |
|---|---|
| 전체 요청 | 12,925 |
| GET · 오브젝트 읽기 | 8,987 |
| LIST · 목록 조회 | 3,924 |
| PUT · 오브젝트 쓰기 | 14 |
위 수치는 제공된 콘솔 화면의 한 시점 표시값을 옮긴 것입니다. 계정·버킷·리전·조회 시각은 여기서도 제외했습니다. 원본 청구 CSV를 분석한 자료가 아니고 이 값만으로 월 청구량이나 “복원을 몇 번 했다”는 횟수를 계산하지도 않았습니다.
복제본인데 왜 S3를 계속 읽을까
정상적인 CNPG 복제본은 Primary에서 WAL을 스트리밍으로 받습니다. 그래서 처음에는 옆에 정상 Primary가 있는데 왜 S3를 읽는지 의아했습니다.
다만 백업 아카이브도 복구 경로로 설정되어 있으면 이야기가 달라집니다. PostgreSQL 문서에 따르면 standby는 시작할 때 아카이브에 있는 WAL을 먼저 복구하고 이후 로컬 WAL과 스트리밍 경로를 시도합니다. 스트리밍을 사용해도 기동 과정에서는 여전히 아카이브에 접근합니다. PostgreSQL standby 동작 설명을 읽고 나니 그래프를 보는 관점도 달라졌습니다.
당시 복제본 로그에서는 체크포인트를 찾지 못해 시작에 실패하는 현상과 WAL 복구 시도가 반복되고 있었습니다. 요청 그래프와 함께 보면 확인해야 할 경로였습니다. 그렇다고 급증한 요청이 모두 특정 Pod 하나에서 나왔다고 입증하지는 않았고 체크포인트 오류만 보고 물리 디스크가 고장 났다고 단정하지도 않았습니다.
Primary에 필요한 WAL을 보존하는 replication slot도 살펴봤습니다. 사용 중인 CNPG 1.27 계열에서는 HA용 slot 관리가 기본 활성화되어 있습니다. 기본으로 켜져 있는 옵션이라 그 옵션을 켜는 것만으로 이번 문제를 해결했다고 볼 근거는 없었습니다. 이 기본값은 CNPG 문서에서 확인했습니다.
재시작을 반복하기보다 새 복제본을 만들기로 했습니다
같은 데이터로 기동 실패를 반복한다면 Pod를 재시작하는 것만으로는 해결되지 않을 수 있습니다. Pod만 지우고 기존 볼륨을 다시 붙이면 같은 문제로 돌아올 수 있기 때문입니다.
정상 Primary와 다른 정상 복제본이 남아 있을 때는 문제가 확인된 복제본의 인스턴스와 볼륨을 정리하고 새 복제본을 Primary에서 다시 만드는 방향을 선택했습니다. CNPG의 인스턴스 폐기 기능도 Pod와 연결된 PVC를 함께 제거합니다. CNPG의 인스턴스 폐기 설명을 참고했습니다.
자동화는 대상 복제본을 지우기 전에 먼저 펜싱합니다. PostgreSQL을 멈춰 복구 요청이 계속 발생하는 것을 제한하고 정지 상태를 확인한 다음 정리하는 순서입니다. CNPG 펜싱은 이런 인스턴스 격리에 사용하는 기능입니다. Primary는 자동 삭제 대상에서 제외했습니다.
Python으로 장애 판정과 재생성을 자동화했습니다
별도 보조 컨트롤러를 Python으로 구현했습니다. 주기적으로 새 작업 Pod를 만드는 방식보다는 작은 컨트롤러 하나를 계속 실행하는 쪽을 택했습니다. 이 컨트롤러가 여러 CNPG 클러스터의 상태와 오류를 관찰합니다. 기존 CNPG Operator가 맡는 복제본 생성은 그대로 두고 어떤 복제본을 교체할지 판단하는 부분을 보탰습니다.
비정상 상태 가운데 삭제 사유로 삼는 것은 체크포인트 복구 불가, 필수 WAL 부재로 인한 되감기 실패, 필요한 WAL의 유실, 같은 위치에서 반복되는 WAL 불일치의 네 가지로 좁혔습니다. 같은 시작 과정에서 나온 로그 여러 줄은 실패 한 번으로 세고 오류의 반복과 복구 진행 여부를 함께 봅니다.
정상 Primary와 별도 정상 복제본이 있는지, 역할 전환 중은 아닌지 확인하고 한 번에 한 복제본만 처리합니다. 새 복제본에서도 문제가 반복되면 계속 지우는 대신 멈추고 알립니다. 활성화하기 전부터 비정상이던 Pod도 자동 처리에서 제외했습니다.
완료 기준에는 스토리지 정리도 넣었습니다. 새 복제본이 스트리밍 복제에 합류했는지와 별도로 옛 PVC와 PV가 사라졌는지, Ceph RBD 이미지와 trash에도 남아 있지 않은지 확인합니다. 실제 삭제는 스토리지 드라이버에 맡겼고 컨트롤러가 Ceph 이미지 자체를 강제로 지우지는 않습니다.
WAL을 어느 소스에서도 구하지 못했을 때의 재시도 간격은 60초로 늘렸습니다. 정상 스트리밍에 60초 지연을 넣거나 모든 S3 요청을 분당 한 번으로 제한하는 설정이 아니라 WAL을 구하지 못해 재시도할 때만 적용됩니다. 이 설정이 적용되는 범위는 PostgreSQL의 WAL 재시도 설명을 기준으로 구분했습니다.
복구 알림과 컨트롤러 종료 알림도 붙였습니다
복구 시작·완료·실패는 전용 Discord 알림으로 보내도록 했습니다. 주소는 암호화해서 보관하고 글이나 로그에는 남기지 않았습니다. 같은 작업의 알림이 반복되지 않도록 전송 기록도 관리합니다.
이 컨트롤러가 멈추면 자동 복구 감시도 멈추므로 정상 종료나 재배포 때도 종료 절차가 시작됐다는 메시지를 보냅니다. Kubernetes의 종료 훅을 이용했고 종료 알림을 보내기 전에 새 삭제 작업부터 막습니다. 노드 전원 장애처럼 종료 코드를 실행할 수 없는 상황은 별도 감시가 필요한 영역으로 남습니다.
관찰 모드부터 확인하고 운영에 켰습니다
처음에는 자동 삭제를 끈 관찰 모드로 배포했습니다. 이때는 DB를 수정하거나 삭제하는 권한도 빼 두고 실행 환경과 조회 경로부터 확인했습니다.
| 확인한 항목 | 결과 |
|---|---|
| 오류 판정과 안전장치 단위 테스트 | 38개 통과 |
| 세 CNPG 클러스터의 메트릭 조회 | 정상 |
| PVC·PV와 Ceph RBD 매핑 및 목록 조회 | 정상 |
| Discord 검증 메시지와 실제 정상 종료 알림 | 전송 성공 |
| 관찰용 Pod·Secret·권한 등 임시 리소스 | 검증 후 전부 정리 |
관찰 검증을 마친 뒤 GitOps로 운영 배포하고 자동 복구를 활성화했습니다. 컨트롤러 기동, 작업 권한과 리더십, 세 클러스터의 재시도 간격 반영까지 확인했습니다.
여기까지가 오늘 확인한 범위입니다. 운영 DB에 일부러 장애를 내 실제 Pod와 PVC를 지우고 재생성하는 전체 과정까지는 시험하지 않았습니다. 자동화가 실제 장애를 처리한 결과나 비용 절감액도 아직 수치로 측정하지 않았습니다.
백업 횟수를 줄이려고 시작한 작업은 복구 시도가 반복될 때 어디서 멈추고 언제 새 복제본으로 교체할지 정하는 작업으로 바뀌었습니다. 당장은 백업을 덜 남기는 일보다 실패한 복구가 계속 요청을 만드는 상황을 제한하는 쪽이 먼저라고 보고 기준과 알림을 마련했습니다.
답글 남기기